9.1 序列模型
让我们先来看看这些场景:
#深度学习#PyTorch#动手学深度学习#循环神经网络
17 篇文章 · 查看全部标签
让我们先来看看这些场景:
假设一台机器有 $k$ 个GPU。 给定需要训练的模型,虽然每个GPU上的参数值都是相同且同步的,但是每个GPU都将独立地维护一组完整的模型参数。
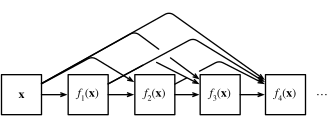
DenseNet 使用了一种极简的连接模式:为了确保网络中最大程度的信息流动,将所有层(以匹配的特征图大小)直接连接起来。
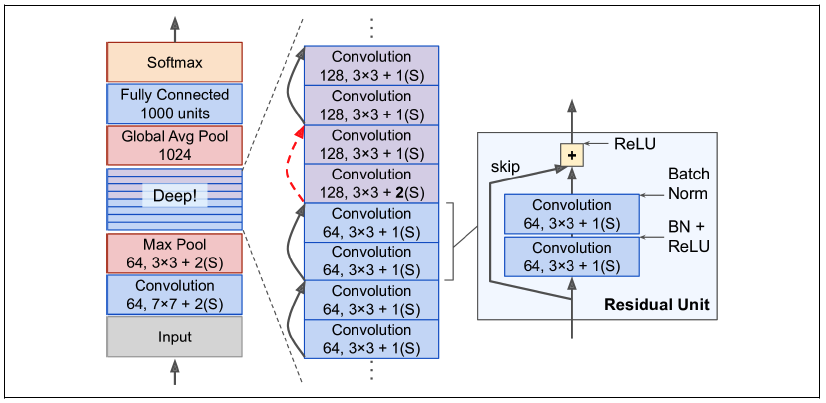
随着网络层数加深,一个关键问题浮现:新添加的层到底能不能提升网络性能?
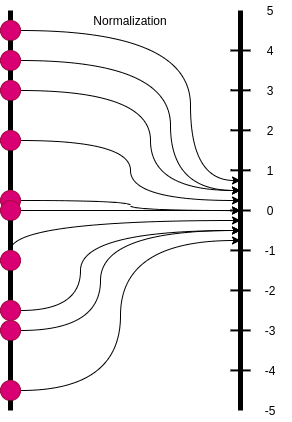
批量归一化(Batch Normalization) 的首次提出,是为了减少内部协变量偏移(Internal Covariate Shift)。
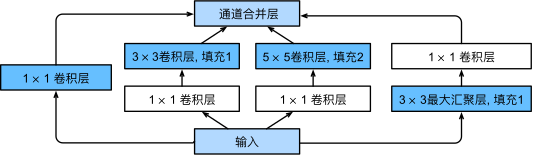
在GoogLeNet中,基本的卷积块被称为Inception块(Inception block)。这很可能得名于电影《盗梦空间》(Inception),因为电影中的一句话“我们需要走得更深”(“We need to go deeper”)。
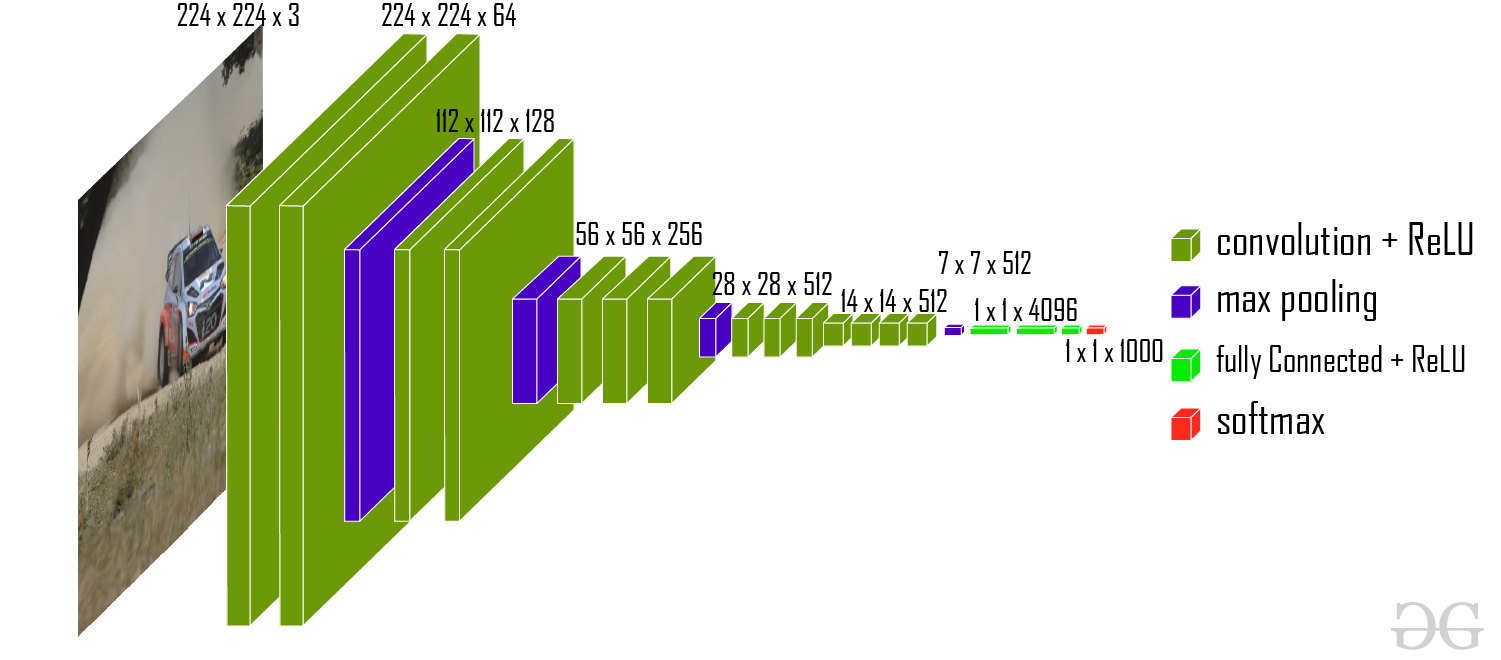
AlexNet比LeNet更深更大,获得了更大的精度,那我们能不能更深更大?这是一种自然而然的想法。
LeNet、AlexNet和VGG都有一个共同的设计模式:通过一系列的卷积层与汇聚层来提取空间结构特征;然后通过全连接层对特征的表征进行处理。其中,AlexNet和VGG对LeNet做出了朴素的改进,即做得 “更深更大”。然而,如果使用了全连接层,会带来一些问题:
2012年,AlexNet横空出世。它首次证明了学习到的特征可以超越手工设计的特征。它一举打破了计算机视觉研究的现状。 AlexNet使用了8层卷积神经网络,并以很大的优势赢得了2012年ImageNet图像识别挑战赛。
我们对原始模型做了一点小改动,去掉了最后一层的高斯激活。除此之外,这个网络与最初的LeNet-5一致。
高度和宽度分别为 $h$ 和 $w$ 的卷积核可以被称为 $h\times w$ 卷积或 $h\times w$ 卷积核。我们也将带有 $h\times w$ 卷积核的卷积层称为 $h\times w$ 卷积层。
我们使用Fashion-MNIST数据集,定义具有两个隐藏层的多层感知机,每个隐藏层包含256个单元。
首先,我们生成一些数据,公式如下:
我们将使用以下三阶多项式生成训练和测试数据:
4.2-4.3 多层感知机的实现
对于一张图片输入${\bf{x}}\in(28\times28)$,转化为行向量${\bf{x}}\in(1\times784)$,与权重${\bf{W}}\in(784\times10)$做乘法后加上偏差${\bf{b}}\in(1\times10)$,得到结果矩阵$(1\times10)$
嘿嘿,第一篇笔记⎛⎝≥⏝⏝≤⎛⎝