4.6 Dropout 的代码实现
- 定义
dropout_layer函数
import torchfrom torch import nnfrom d2l import torch as d2l
def dropout_layer(X, dropout): assert 0 <= dropout <= 1 #丢弃所有元素 if dropout == 1: return torch.zeros_like(X) #保留所有元素 if dropout == 0: return X mask = (torch.rand(X.shape) > dropout).float() # 注意是.rand()不是.randn() return mask * X / (1.0 - dropout)- 定义模型
我们使用Fashion-MNIST数据集,定义具有两个隐藏层的多层感知机,每个隐藏层包含256个单元。
num_inputs, num_outputs, num_hiddens1, num_hiddens2 = 784, 10, 256, 256
dropout1, dropout2 = 0.2, 0.5
class Net(nn.Module): def __init__(self, num_inputs, num_outputs, num_hiddens1, num_hiddens2, is_training = True): super().__init__() self.num_inputs = num_inputs self.training = is_training self.lin1 = nn.Linear(num_inputs, num_hiddens1) self.lin2 = nn.Linear(num_hiddens1, num_hiddens2) self.lin3 = nn.Linear(num_hiddens2, num_outputs) self.relu = nn.ReLU()
def forward(self, X): H1 = self.relu(self.lin1(X.reshape(-1, self.num_inputs))) # 只有在训练模型时才使用dropout if self.training == True: # 在第一个全连接层之后添加一个dropout层 H1 = dropout_layer(H1, dropout1) H2 = self.relu(self.lin2(H1)) if self.training == True: # 在第二个全连接层之后添加一个dropout层 H2 = dropout_layer(H2, dropout2) out = self.lin3(H2) return out
net = Net(num_inputs, num_outputs, num_hiddens1, num_hiddens2)在靠近输入层的地方设置较低的暂退概率是常见的技巧。
为了对照,我们再定义一个Net2类,继承自Net,去掉Dropout操作,其他不变。
class Net2(Net): def __init__(self, num_inputs, num_outputs, num_hiddens1, num_hiddens2, is_training = True): super().__init__(num_inputs, num_outputs, num_hiddens1, num_hiddens2, is_training = True)
def forward(self, X): H1 = self.relu(self.lin1(X.reshape(-1, num_inputs))) H2 = self.relu(self.lin2(H1)) out = self.lin3(H2) return out
net2 = Net2(num_inputs, num_outputs, num_hiddens1, num_hiddens2)- 训练和测试
num_epochs, lr, batch_size = 10, 0.5, 256loss = nn.CrossEntropyLoss(reduction='none')train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)先来试试有Dropout,再试试没有Dropout。
trainer = torch.optim.SGD(net.parameters(), lr=lr)d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)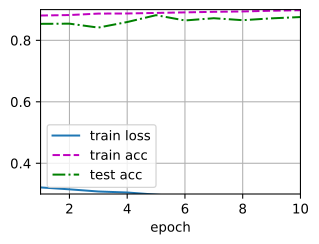
trainer2 = torch.optim.SGD(net2.parameters(), lr=lr)d2l.train_ch3(net2, train_iter, test_iter, loss, num_epochs, trainer2)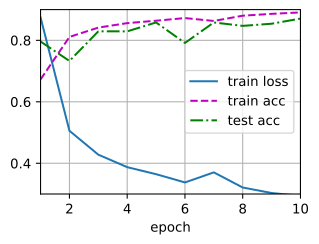
- 简洁实现
net = nn.Sequential(nn.Flatten(), nn.Linear(784, 256), nn.ReLU(), nn.Dropout(dropout1), nn.Linear(256, 256), nn.ReLU(), nn.Dropout(dropout2), nn.Linear(256, 10))
def init_weights(m): if type(m) == nn.Linear: nn.init.normal_(m.weight, std=0.01)
net.apply(init_weights)
trainer = torch.optim.SGD(net.parameters(), lr=lr)d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)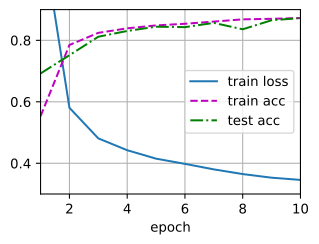
本文由 kaikaikk 原创,发布于
;
转载请保留原文链接:
https://kaikaikk.com/posts/d2l-4-6-dropout/