7.4 含并行连结的网络(GoogLeNet)
Inception块
在GoogLeNet中,基本的卷积块被称为Inception块(Inception block)。这很可能得名于电影《盗梦空间》(Inception),因为电影中的一句话“我们需要走得更深”(“We need to go deeper”)。
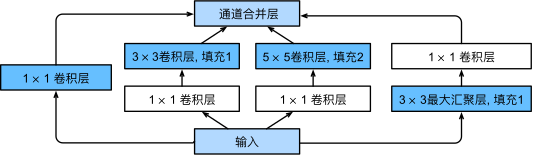
如图1,输出和输入等高等宽,将4条路径结果按通道合并:
- 前三条路径使用窗口大小为 、 和 卷积层从不同空间大小中提取信息。
- 中间两条路径执行 卷积,以减少通道数,降低模型复杂性。
- 第四条路径使用 最大池化层,然后使用 改变通道数。
跟单 或 卷积层比,Inception块有更少的参数个数和计算复杂度。
| #parameters | FLOPS | |
|---|---|---|
| Inception | 0.16M | 128M |
| Conv | 0.44M | 346M |
| Conv | 1.22M | 963M |
import torchfrom torch import nnfrom torch.nn import functional as Ffrom d2l import torch as d2l
class Inception(nn.Module): # c1--c4是每条路径的输出通道数 def __init__(self, in_channels, c1, c2, c3, c4, **kwargs): super(Inception, self).__init__(**kwargs) # 线路1,单1x1卷积层 self.p1_1 = nn.Conv2d(in_channels, c1, kernel_size=1) # 线路2,1x1卷积层后接3x3卷积层 self.p2_1 = nn.Conv2d(in_channels, c2[0], kernel_size=1) self.p2_2 = nn.Conv2d(c2[0], c2[1], kernel_size=3, padding=1) # 线路3,1x1卷积层后接5x5卷积层 self.p3_1 = nn.Conv2d(in_channels, c3[0], kernel_size=1) self.p3_2 = nn.Conv2d(c3[0], c3[1], kernel_size=5, padding=2) # 线路4,3x3最大汇聚层后接1x1卷积层 self.p4_1 = nn.MaxPool2d(kernel_size=3, stride=1, padding=1) self.p4_2 = nn.Conv2d(in_channels, c4, kernel_size=1)
def forward(self, x): p1 = F.relu(self.p1_1(x)) p2 = F.relu(self.p2_2(F.relu(self.p2_1(x)))) p3 = F.relu(self.p3_2(F.relu(self.p3_1(x)))) p4 = F.relu(self.p4_2(self.p4_1(x))) # 在通道维度上连结输出 return torch.cat((p1, p2, p3, p4), dim=1)那么为什么GoogLeNet这个网络如此有效呢? 首先我们考虑一下滤波器(filter)的组合,它们可以用各种滤波器尺寸探索图像,这意味着不同大小的滤波器可以有效地识别不同范围的图像细节。 同时,我们可以为不同的滤波器分配不同数量的参数。
GoogLeNet模型
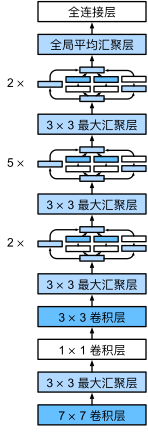
如图2所示,GoogLeNet一共使用9个Inception块和全局平均汇聚层的堆叠来生成其估计值。Inception块之间的最大汇聚层可降低维度。 第一个模块类似于AlexNet和LeNet,Inception块的组合从VGG继承,全局平均汇聚层避免了在最后使用全连接层。
现在,我们逐一实现(照着抄)GoogLeNet的每个模块。
- 第一个模块: 使用64个通道、 卷积层
b1 = nn.Sequential(nn.Conv2d(1, 64, kernel_size=7, stride=2, padding=3), nn.ReLU(), nn.MaxPool2d(kernel_size=3, stride=2, padding=1) )- 第二个模块:使用两个卷积层,对应Inception块中第二条路径。
- 64个通道、 卷积层
- 通道数增三倍的 卷积层
b2 = nn.Sequential(nn.Conv2d(64, 64, kernel_size=1), nn.ReLU(), nn.Conv2d(64, 192, kernel_size=3, padding=1), nn.ReLU(), nn.MaxPool2d(kernel_size=3, stride=2, padding=1) )- 第三个模块:串联两个完整的Inception块,输出通道分别是256和480。
b3 = nn.Sequential(Inception(192, 64, (96, 128), (16, 32), 32), Inception(256, 128, (128, 192), (32, 96), 64), nn.MaxPool2d(kernel_size=3, stride=2, padding=1) )- 第四个模块:串联了5个Inception块,输出通道数分别是512、512、512、528和832。
b4 = nn.Sequential(Inception(480, 192, (96, 208), (16, 48), 64), Inception(512, 160, (112, 224), (24, 64), 64), Inception(512, 128, (128, 256), (24, 64), 64), Inception(512, 112, (144, 288), (32, 64), 64), Inception(528, 256, (160, 320), (32, 128), 128), nn.MaxPool2d(kernel_size=3, stride=2, padding=1) )- 第五个模块:包含输出通道为832和1024的两个Inception块。其后紧跟输出层,和NiN一样使用全局平均池化层,将每个通道变为 。最后我们将输出变成二维数组,再接上一个输出个数为标签类别数的全连接层。
这些猎奇的通道数是怎么搞出来了?托梦?
b5 = nn.Sequential(Inception(832, 256, (160, 320), (32, 128), 128), Inception(832, 384, (192, 384), (48, 128), 128), nn.AdaptiveAvgPool2d((1,1)), nn.Flatten() )
net = nn.Sequential(b1, b2, b3, b4, b5, nn.Linear(1024, 10))为了使Fashion-MNIST上的训练短小精悍,我们将输入的高和宽从224降到96。
X = torch.rand(size=(1, 1, 96, 96))for layer in net: X = layer(X) print(layer.__class__.__name__,'output shape:\t', X.shape)Sequential output shape: torch.Size([1, 64, 24, 24])Sequential output shape: torch.Size([1, 192, 12, 12])Sequential output shape: torch.Size([1, 480, 6, 6])Sequential output shape: torch.Size([1, 832, 3, 3])Sequential output shape: torch.Size([1, 1024])Linear output shape: torch.Size([1, 10])训练模型
lr, num_epochs, batch_size = 0.1, 10, 128train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=96)d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())loss 0.244, train acc 0.907, test acc 0.8772316.6 examples/sec on cuda:0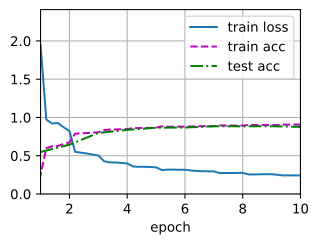
一些改进
以上的Inception是v1版本,后来提出了一些改进版本:
- Inception-BN(V2):使用了 batch normalization
- Inception-V3:修改了 Inception(包含诡异的 、 、 、 Conv)
- Inception-V4:使用残差连接
小结
-
Inception块相当于一个有4条路径的子网络。它通过不同窗口形状的卷积层和最大汇聚层来并行抽取信息,并使用 卷积层减少每像素级别上的通道维数从而降低模型复杂度。
-
GoogLeNet将多个设计精细的Inception块与其他层(卷积层、全连接层)串联起来。其中Inception块的通道数分配之比是在ImageNet数据集上通过大量的实验得来的。
-
GoogLeNet和它的后继者们一度是ImageNet上最有效的模型之一:它以较低的计算复杂度提供了类似的测试精度。