7.5 批量归一化
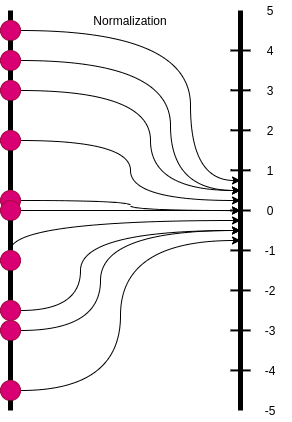
批量归一化(Batch Normalization) 的首次提出,是为了减少内部协变量偏移(Internal Covariate Shift)。
也就是说,在深度网络中,每一层的输入数据在经过运算后分布一直发生变化,前面层训练参数的更新将导致后面层输入数据分布的变化,必然会引起后面每一层输入数据分布的改变,不再是输入的原始数据所适应的分布了,而且这样的微小变化会被逐层放大。
- 带来的麻烦: 每层都要不断适应新的输入分布,导致收敛极其缓慢;且数据容易落入激活函数(如Sigmoid)的两端饱和区,引发梯度消失。
- BN的初衷: 对每一层的输入进行归一化,强制将其分布拉回均值0、方差1的标准正态分布,让数据始终处于激活函数的敏感区域,从而稳定梯度。
算法执行(前向传播)
对于一个包含 个样本的 小批量(Mini-batch) 数据 ,BN 按以下顺序操作:
-
计算批量均值():
-
计算批量方差():
-
归一化(将分布拉回标准正态): (其中 是一个极小常数,防止分母为 0)
-
缩放与平移(重构变换)——这是 BN 最关键的一步:
- 其中 (缩放)和 (偏移)是可学习的参数。
为什么要加这一步?
如果只有第 3 步,强行把数据限制在标准正态分布,会破坏该层原有的特征表达能力(比如原本数据需要非对称分布才能表达特征)。引入 和 ,网络可以“学回来”最优的分布形态,既享受了归一化的稳定收益,又保留了模型的容量。
批量归一化层
通常,我们把批量归一化层作用在全连接层或卷积层之后,激活函数之前。
- 对于全连接层,作用在特征维。
- 对于卷积层,作用于通道维。
批量归一化的作用及原理
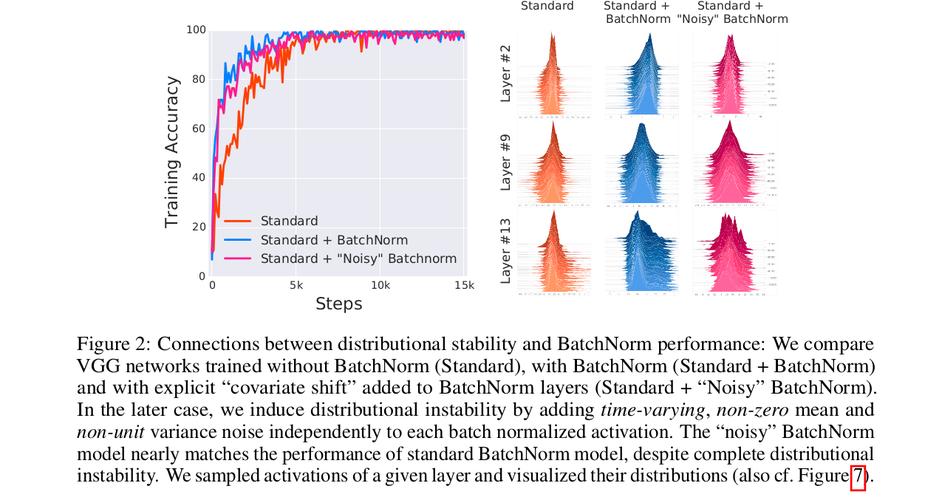
如图2,从左侧图可看出加入 BatchNorm 后,训练精读收敛得更快,同时抖动更小(但不改变最终的精度);从右侧图可看出加入 BatchNorm 后,各层输出分布更加“均衡”。
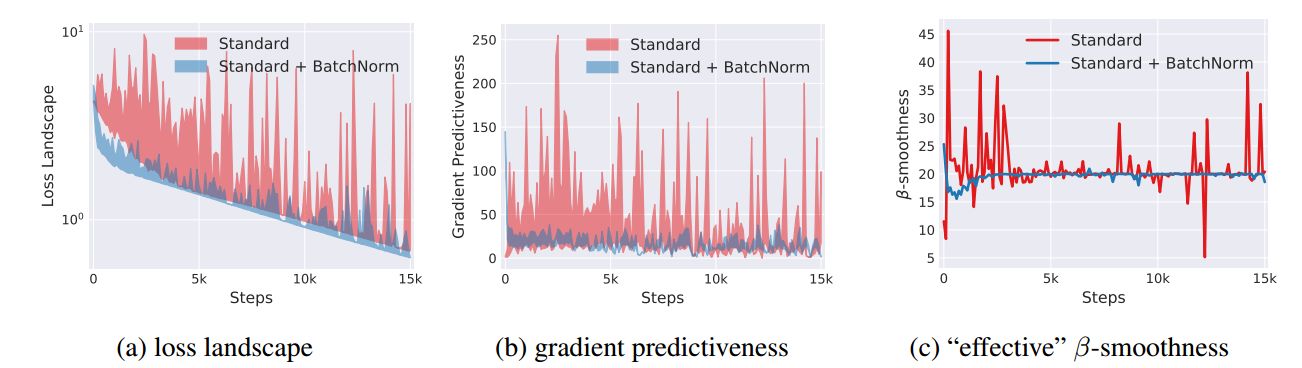
如图3,可以看出BN会让损失面和梯度行为更平滑、更可预测,从而允许使用更大的学习率,并降低训练不稳定的风险。
关于其作用原理 :
- 最初的论文表示可以减少内部协变量转移
- 后续论文提出了一些其他见解
- 允许更大的学习率。
- 轻微的正则化效果(削弱过拟合),因为训练时均值和方差是基于“当前小批量”估算的,带有一定的随机噪声,这等同于给模型加入了噪声干扰,类似 Dropout,能提高泛化能力。
- 让损失函数变得更加平滑,使得梯度下降时的每一步都更稳定、更可预测。
从零实现
下面,我们从头开始实现一个具有张量的批量归一化层。
import torchfrom torch import nnfrom d2l import torch as d2l
def batch_norm(X, gamma, beta, moving_mean, moving_var, eps, momentum): # 通过is_grad_enabled来判断当前模式是训练模式还是预测模式 if not torch.is_grad_enabled(): # 如果是在预测模式下,直接使用传入的移动平均所得的均值和方差 X_hat = (X - moving_mean) / torch.sqrt(moving_var + eps) else: assert len(X.shape) in (2, 4) if len(X.shape) == 2: # 使用全连接层的情况,计算特征维上的均值和方差 mean = X.mean(dim=0) var = ((X - mean) ** 2).mean(dim=0) else: # 使用二维卷积层的情况,计算通道维上(dim=1)的均值和方差 # 这里我们需要保持X的形状以便后面可以做广播运算 mean = X.mean(dim=(0, 2, 3), keepdim=True) var = ((X - mean) ** 2).mean(dim=(0, 2, 3), keepdim=True) # 训练模式下,用当前的均值和方差做标准化 X_hat = (X - mean) / torch.sqrt(var + eps) # 更新移动平均的均值和方差 moving_mean = momentum * moving_mean + (1.0 - momentum) * mean moving_var = momentum * moving_var + (1.0 - momentum) * var Y = gamma * X_hat + beta # 缩放和移位 return Y, moving_mean.data, moving_var.data
momentum通常取0.9,这里是 指数加权移动平均(EWMA)。
全连接层的“特征维”恰好是最后一维(尾部),而卷积层的“通道维”在中间(非尾部)。PyTorch 的广播机制是从 尾部(最后一维) 开始对齐的,所以全连接层不需要
keepdim就能天然匹配,而卷积层不加keepdim就会对位错误。
我们现在可以创建一个正确的BatchNorm层。 这个层将保持适当的参数:拉伸gamma和偏移beta(使用nn.Parameter),这两个参数将在训练过程中更新。 此外,我们的层将保存均值和方差的移动平均值,以便在模型预测期间随后使用。
class BatchNorm(nn.Module): # num_features:完全连接层的输出数量或卷积层的输出通道数。 # num_dims:2表示完全连接层,4表示卷积层 def __init__(self, num_features, num_dims): super().__init__() if num_dims == 2: shape = (1, num_features) else: shape = (1, num_features, 1, 1) # 参与求梯度和迭代的拉伸和偏移参数,分别初始化成1和0 self.gamma = nn.Parameter(torch.ones(shape)) self.beta = nn.Parameter(torch.zeros(shape)) # 非模型参数的变量初始化为0和1 self.moving_mean = torch.zeros(shape) self.moving_var = torch.ones(shape)
def forward(self, X): # 如果X在GPU上,将moving_mean和moving_var复制到GPU上 if self.moving_mean.device != X.device: self.moving_mean = self.moving_mean.to(X.device) self.moving_var = self.moving_var.to(X.device) # 保存更新过的moving_mean和moving_var Y, self.moving_mean, self.moving_var = batch_norm( X, self.gamma, self.beta, self.moving_mean, self.moving_var, eps=1e-5, momentum=0.9 ) return Y我们将BatchNorm应用于LeNet模型上。与之前的训练不同的是,我们这次设置的学习率更大。
net = nn.Sequential( nn.Conv2d(1, 6, kernel_size=5), BatchNorm(6, num_dims=4), nn.Sigmoid(), nn.AvgPool2d(kernel_size=2, stride=2), nn.Conv2d(6, 16, kernel_size=5), BatchNorm(16, num_dims=4), nn.Sigmoid(), nn.AvgPool2d(kernel_size=2, stride=2), nn.Flatten(), nn.Linear(16 * 4 * 4, 120), BatchNorm(120, num_dims=2), nn.Sigmoid(), nn.Linear(120, 84), BatchNorm(84, num_dims=2), nn.Sigmoid(), nn.Linear(84, 10))
lr, num_epochs, batch_size = 1.0, 10, 256train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())loss 0.268, train acc 0.900, test acc 0.86044842.0 examples/sec on cuda:0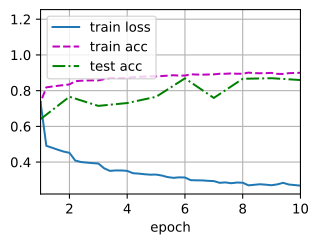
让我们来看看从第一个批量规范化层中学到的拉伸参数gamma和偏移参数beta。
net[1].gamma.reshape((-1,)), net[1].beta.reshape((-1,))(tensor([4.2132, 2.2393, 2.7753, 3.0132, 2.9366, 2.0075], device='cuda:0', grad_fn=<ViewBackward0>), tensor([-2.6978, 0.4657, -2.7125, 3.3042, 0.9594, 1.8430], device='cuda:0', grad_fn=<ViewBackward0>))简明实现
除了使用我们刚刚定义的BatchNorm,我们也可以直接使用深度学习框架中定义的BatchNorm。 该代码看起来几乎与我们上面的代码相同(注意BatchNorm2d和BatchNorm1d的区别)。
net = nn.Sequential( nn.Conv2d(1, 6, kernel_size=5), nn.BatchNorm2d(6), nn.Sigmoid(), nn.AvgPool2d(kernel_size=2, stride=2), nn.Conv2d(6, 16, kernel_size=5), nn.BatchNorm2d(16), nn.Sigmoid(), nn.AvgPool2d(kernel_size=2, stride=2), nn.Flatten(), nn.Linear(256, 120), nn.BatchNorm1d(120), nn.Sigmoid(), nn.Linear(120, 84), nn.BatchNorm1d(84), nn.Sigmoid(), nn.Linear(84, 10))
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())loss 0.263, train acc 0.902, test acc 0.81984687.7 examples/sec on cuda:0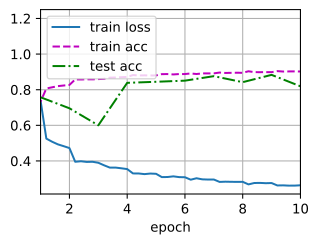
通常高级API变体运行速度快得多,因为它的代码已编译为C++或CUDA,而我们的自定义代码由Python实现。
小结
-
在模型训练过程中,批量规范化利用小批量的均值和标准差,不断调整神经网络的中间输出,使整个神经网络各层的中间输出值更加稳定。
-
批量规范化在全连接层和卷积层的使用略有不同。
-
批量规范化层和Dropout层一样,在训练模式和预测模式下计算不同。
-
批量规范化有许多有益的副作用,主要是正则化。另一方面,”减少内部协变量偏移“的原始动机似乎不是一个有效的解释。