9.1 序列模型
让我们先来看看这些场景:
- 随着时间的推移,人们对电影的看法会发生很大的变化。
- 预测明天的股价要比过去的股价更困难。
- 在本质上,音乐、语音、文本和视频都是连续的。
- 人类之间的互动也是连续的。
与之前处理单个特征向量的模型不同,处理序列时输入变为一个有序的特征向量列表 ,每个特征向量 由时间步 索引。
序列预测任务有多种形式:根据序列输入预测固定目标(如情感分类)、根据固定输入预测序列目标(如图像描述)、以及序列到序列的任务(如机器翻译)。最基础的问题是无监督密度建模(也称序列建模),即估计看到任意给定序列的概率 。
自回归模型
以股票价格数据为例,交易者希望根据历史价格预测下一时刻的价格,即估计条件分布:
用信号的历史值来回归该信号当前值的模型,自然被称为自回归模型。核心挑战在于:输入 的数量随 变化,每个样本的特征数量不同。而克服这一挑战的策略有:
- 只使用最近 个观测值 ,使输入维度固定。
- 维护一个对过去观测的总结 ,同时更新 和预测 :,。由于 不可观测,这类模型也称为隐变量自回归模型。
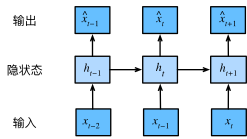
序列模型
有时我们需要估计整个序列的联合概率,这类函数称为序列模型;对于自然语言数据,则称为语言模型。语言模型不仅用于评估似然性,还可用于采样序列和优化最可能的序列。
通过概率链式法则,可以将序列的联合密度分解为从左到右的条件密度乘积:
对于离散信号(如单词),自回归模型必须是一个概率分类器,输出给定左向上下文时下一个词在整个词表上的概率分布。
马尔科夫模型
如果我们只依赖最近 个时间步 而非完整历史,且不损失预测能力,则称序列满足马尔可夫条件——即给定近期历史,未来与过去条件独立。
- :一阶马尔可夫模型,联合概率分解为
- : 阶马尔可夫模型
对于离散数据,真正的马尔可夫模型只需统计每个上下文中各词出现的次数,产生相对频率估计。
解码顺序
为什么不从右到左或按其他顺序分解?虽然反向分解也是有效的,但从左到右(阅读方向)的分解有几个优势:
- 这是更自然的思考方向——我们每天都在预测下一个词是什么。
- 按顺序分解可以用同一个语言模型为任意长度的序列分配概率——只需乘以新增词的条件概率。
- 预测相邻词比预测任意位置的词更容易。
此外,对于因果结构的数据(如时间向前流动),改变 可能影响 ,但反过来不成立,因此预测 通常比预测 更容易。
训练
这里采用中文版的代码,较新的英文版代码放在最后
使用合成的正弦波数据(外加噪声)进行实验。假设数据满足 阶马尔可夫条件,用过去 个观测值预测 。每个样本的标签为 ,特征为 。
数据集包含 个样本(前 个因缺少足够历史而被丢弃),每个输入的长度为 。使用前 600 个样本进行训练,采用标准线性回归模型。
%matplotlib inlineimport torchfrom torch import nnfrom d2l import torch as d2l
T = 1000 # 总共产生1000个点time = torch.arange(1, T + 1, dtype=torch.float32)x = torch.sin(0.01 * time) + torch.normal(0, 0.2, (T,))d2l.plot(time, [x], 'time', 'x', xlim=[1, 1000], figsize=(6, 3))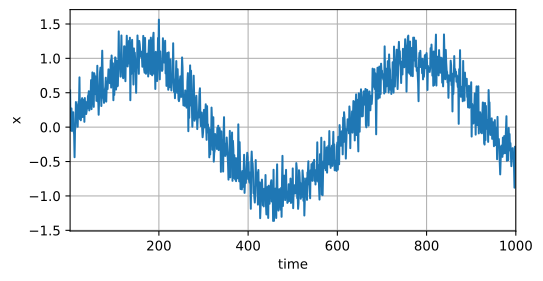
接下来,我们将这个序列转换为模型的特征-标签(feature-label)对。
这里的赋值写得真漂亮…
tau = 4features = torch.zeros((T - tau, tau)) # (样本数,特征数)for i in range(tau): features[:, i] = x[i: T - tau + i]labels = x[tau:].reshape(-1, 1)
batch_size, n_train = 16, 600# 只有前n_train个样本用于训练train_iter = d2l.load_array((features[:n_train], labels[:n_train]), batch_size, is_train=True)我们使用一个相当简单的架构训练模型: 一个拥有两个全连接层的多层感知机,ReLU激活函数和平方损失。
# 初始化网络权重的函数def init_weights(m): if type(m) == nn.Linear: nn.init.xavier_uniform_(m.weight)
def get_net(): net = nn.Sequential(nn.Linear(4, 10), nn.ReLU(), nn.Linear(10, 1)) net.apply(init_weights) return net
loss = nn.MSELoss(reduction='none')
def train(net, train_iter, loss, epochs, lr): trainer = torch.optim.Adam(net.parameters(), lr) for epoch in range(epochs): for X, y in train_iter: trainer.zero_grad() l = loss(net(X), y) l.sum().backward() trainer.step() print(f'epoch {epoch + 1}, ' f'loss: {d2l.evaluate_loss(net, train_iter, loss):f}')
net = get_net()train(net, train_iter, loss, 5, 0.01)epoch 1, loss: 0.054171epoch 2, loss: 0.057454epoch 3, loss: 0.055111epoch 4, loss: 0.053738epoch 5, loss: 0.055068
D:\miniforge3\envs\study\Lib\site-packages\d2l\torch.py:3205: UserWarning: Converting a tensor with requires_grad=True to a scalar may lead to unexpected behavior.Consider using tensor.detach() first. (Triggered internally at C:\actions-runner\_work\pytorch\pytorch\torch\csrc\autograd\generated\python_variable_methods.cpp:839.) self.data = [a + float(b) for a, b in zip(self.data, args)]预测
首先是检查模型预测下一个时间步的能力, 也就是单步预测(one-step-ahead prediction)。
onestep_preds = net(features)d2l.plot([time, time[tau:]], [x.detach().numpy(), onestep_preds.detach().numpy()], 'time', 'x', legend=['data', '1-step preds'], xlim=[1, 1000], figsize=(6, 3))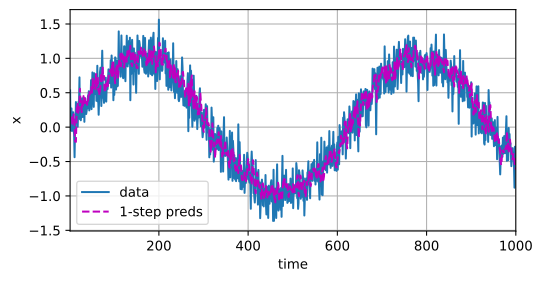
对于观测序列 ,在时间步 的预测输出称为 步预测(-step-ahead-prediction)。
multistep_preds = torch.zeros(T)multistep_preds[: n_train + tau] = x[: n_train + tau]for i in range(n_train + tau, T): multistep_preds[i] = net( multistep_preds[i - tau: i].reshape(1, -1) )
d2l.plot([time, time[tau:], time[n_train + tau:]], [x.detach().numpy(), onestep_preds.detach().numpy(), multistep_preds[n_train + tau:].detach().numpy()], 'time', 'x', legend=['data', '1-step preds', 'multistep preds'], xlim=[1, 1000], figsize=(6, 3))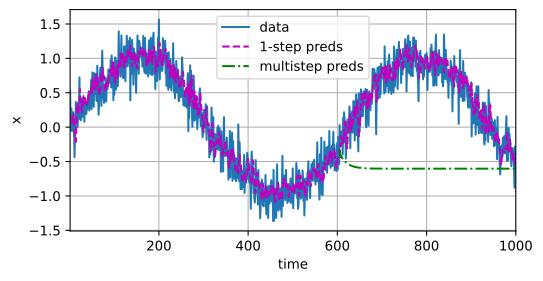
可以看到,绿线的预测显然并不理想。原因是误差累积:第一步有误差 ,第二步的输入被 扰动,误差变为 ,如此不断放大。
基于 ,通过对整个序列预测的计算, 让我们更仔细地看一下 步预测的困难。
max_steps = 64
features = torch.zeros(T - tau - max_steps + 1, tau + max_steps)# 列i(i<tau)是来自x的观测,其时间步从(i)到(i+T-tau-max_steps+1)for i in range(tau): features[:, i] = x[i: i + T - tau - max_steps + 1]
# 列i(i>=tau)是来自(i-tau+1)步的预测,其时间步从(i)到(i+T-tau-max_steps+1)for i in range(tau, tau + max_steps): features[:, i] = net(features[:, i - tau:i]).reshape(-1)
steps = (1, 4, 16, 64)d2l.plot([time[tau + i - 1: T - max_steps + i] for i in steps], [features[:, (tau + i - 1)].detach().numpy() for i in steps], 'time', 'x', legend=[f'{i}-step preds' for i in steps], xlim=[5, 1000], figsize=(6, 3))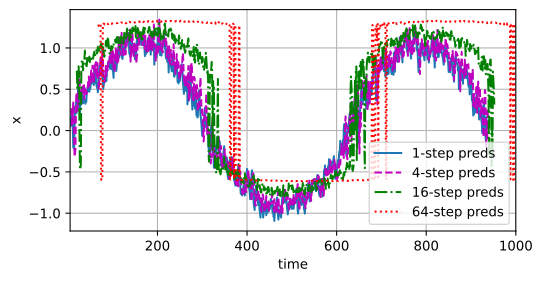
下面是英文版的代码(训练+预测)
class Data(d2l.DataModule): def __init__(self, batch_size=16, T=1000, num_train=600, tau=4): self.save_hyperparameters() self.time = torch.arange(1, T + 1, dtype=torch.float32) self.x = torch.sin(0.01 * self.time) + torch.randn(T) * 0.2
data = Data()d2l.plot(data.time, data.x, 'time', 'x', xlim=[1, 1000], figsize=(6, 3))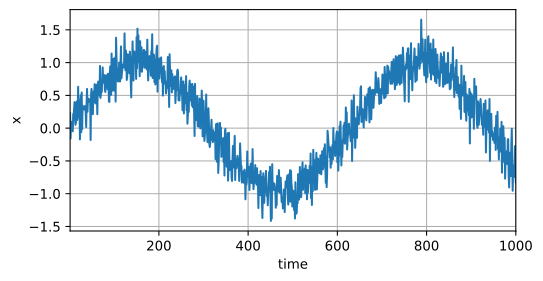
@d2l.add_to_class(Data)def get_dataloader(self, train): features = [self.x[i : self.T-self.tau+i] for i in range(self.tau)] self.features = torch.stack(features, 1) self.labels = self.x[self.tau:].reshape((-1, 1)) i = slice(0, self.num_train) if train else slice(self.num_train, None) return self.get_tensorloader([self.features, self.labels], train, i)
model = d2l.LinearRegression(lr=0.01)trainer = d2l.Trainer(max_epochs=5)trainer.fit(model, data)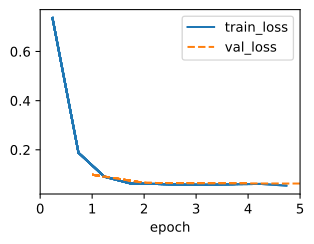
onestep_preds = model(data.features).detach().numpy()d2l.plot(data.time[data.tau:], [data.labels, onestep_preds], 'time', 'x', legend=['labels', '1-step preds'], figsize=(6, 3))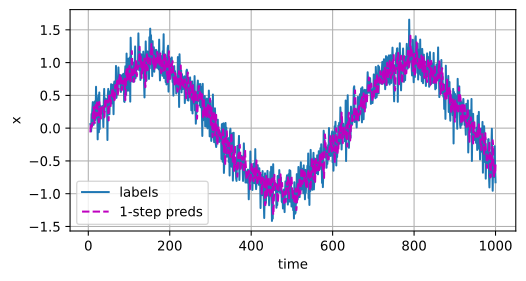
multistep_preds = torch.zeros(data.T)multistep_preds[:] = data.xfor i in range(data.num_train + data.tau, data.T): multistep_preds[i] = model( multistep_preds[i - data.tau:i].reshape((1, -1)))multistep_preds = multistep_preds.detach().numpy()
d2l.plot([data.time[data.tau:], data.time[data.num_train+data.tau:]], [onestep_preds, multistep_preds[data.num_train+data.tau:]], 'time', 'x', legend=['1-step preds', 'multistep preds'], figsize=(6, 3))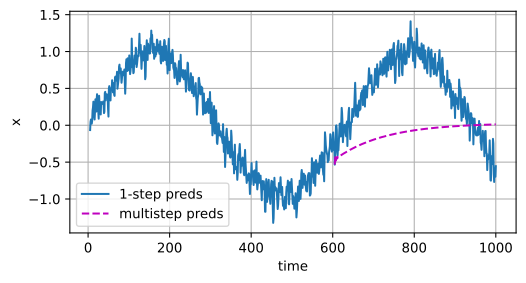
def k_step_pred(k): features = [] for i in range(data.tau): features.append(data.x[i : i+data.T-data.tau-k+1]) # The (i+tau)-th element stores the (i+1)-step-ahead predictions for i in range(k): preds = model(torch.stack(features[i : i+data.tau], 1)) features.append(preds.reshape(-1)) return features[data.tau:]
steps = (1, 4, 16, 64)preds = k_step_pred(steps[-1])d2l.plot(data.time[data.tau+steps[-1]-1:], [preds[k - 1].detach().numpy() for k in steps], 'time', 'x', legend=[f'{k}-step preds' for k in steps], figsize=(6, 3))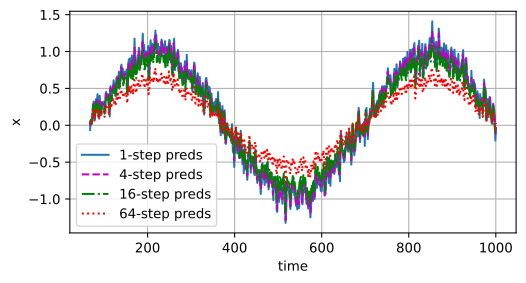
小结
- 插值 vs 外推:两者难度差异巨大。处理序列数据时,必须尊重时间顺序,绝不能用未来的数据训练模型。
- 序列模型需要专门的统计工具:两种常见选择是自回归模型和隐变量自回归模型。
- 因果方向:对于因果模型(如时间向前),估计正向方向通常比反向容易得多。
- -step-ahead 预测:随着 增大,误差累积,预测质量急剧下降。