3.2-3.3 线性回归的实现
嘿嘿,第一篇笔记⎛⎝≥⏝⏝≤⎛⎝
线性回归的从零开始实现
准备工作
%matplotlib inline# 这是一个Jupyter Notebook指令# 意思是“把后面所有画出来的图,直接在一个新窗口展示”import randomimport torchfrom d2l import torch as d2l生成数据集(以线性噪声为例)
我们使用线性模型参数,,定义线性回归函数:
其中为样本噪声。
def synthetic_data(w, b, num_examples): """生成y = Xw + b + 噪声""" X = torch.normal(0, 1, (num_examples, len(w))) # 从平均值为0,标准差为1的正态分布中生成数据 # 数据形状是一个num_examples × len(w)的矩阵,这里是1000行 × 2列 y = torch.matmul(X, w) + b # matmul()是矩阵乘法 y += torch.normal(0, 0.01, y.shape) # 添加噪声 return X, y.reshape(-1, 1) # -1的意思是“这个维度我懒得算,PyTorch小弟交给你了” # 这里把y变成了1000 × 1 的列向量
true_w = torch.tensor([2, -3.4])true_b = 4.2features, labels = synthetic_data(true_w, true_b, 1000)features特征,表示已有数据集,每一行都包含一个二维数据标本。
label标签,表示真值,每一行都包含一个标量。
print('features:', features[0],'\nlabel:', labels[0])features: tensor([-1.2679, 0.8470])label: tensor([-1.2117])通过生成第二个特征features[:, 1]和labels的散点图, 可以直观观察到两者之间的线性关系。
d2l.set_figsize()# 设置画布大小
# d2l.plt.scatter(features[:, 0].detach().numpy(), labels.detach().numpy(), 1);d2l.plt.scatter(features[:, 1].detach().numpy(), labels.detach().numpy(), 1);# detach()取消记录向量的求导信息# numpy()把张量转换成NumPy,画图工具才能认识# 末尾的分号是Jupyter Notebook技巧,隐藏输出的文字信息,只保留图片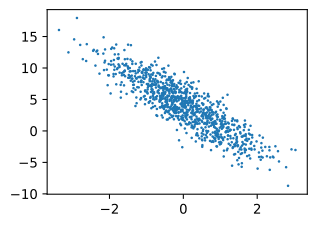
读取数据集
我们定义一个data_iter函数,该函数接受批量大小、特征矩阵和标签向量作为输入,生成大小为batch_size的小批量。每个小批量包含一组特征和标签。
def data_iter(batch_size, features, labels): num_examples = len(features) indices = list(range(num_examples)) # 生成一个与特征等长的序列,这里即为[0, 1, 2, ..., 999] random.shuffle(indices) # 打乱该序列,使样本随机读取 for i in range(0, num_examples, batch_size): batch_indices = torch.tensor( indices[i: min(i + batch_size, num_examples)]) yield features[batch_indices], labels[batch_indices] # 取步长为batch_size,每次运行创建一个长度为10的张量 # 取min是防止最后一轮出现数据不足10个的情况直观感受一下小批量运算:每个批量的特征维度显示批量大小和输入特征数。同样的,标签形状与batch_size相等。
batch_size = 10
for X, y in data_iter(batch_size, features, labels): print(X, '\n', y) breaktensor([[-0.0426, -1.8930], [-2.1043, -0.7073], [-1.0034, 0.6639], [-0.3650, -0.7924], [ 2.0757, 0.2156], [ 0.4934, 0.4802], [ 1.1617, -0.3473], [-0.6336, 0.0179], [-1.7930, 0.3960], [ 1.3175, -0.7012]]) tensor([[10.5597], [ 2.3868], [-0.0716], [ 6.1544], [ 7.6369], [ 3.5645], [ 7.7027], [ 2.8606], [-0.7361], [ 9.2171]])初始化模型参数
在使用小批量随机梯度下降优化模型参数前,先设置一些参数。
这里为什么w要随机初始化,而b直接设置为0呢?
如果w为0,那么所有特征的初始贡献都为0,模型就废了,所以要加一点微小的随机扰动。而b只是一个偏移量,可以放心设0。
w = torch.normal(0, 0.01, size = (2, 1), requires_grad=True)b = torch.zeros(1, requires_grad=True)定义模型
def linreg(X, w, b): """线性回归模型""" return torch.matmul(X, w) + b定义平方差损失函数
def squared_loss(y_hat, y): """均方损失""" return (y_hat - y.reshape(y_hat.shape)) ** 2 / 2定义优化算法
这里使用小批量的随机梯度下降。
下面的函数接收模型参数集合、学习率和批量大小作为输入。每一步更新的大小由学习率(Learning Rate)决定。
def sgd(params, lr, batch_size): """小批量随机梯度下降""" with torch.no_grad(): # 更新参数不需要求导 for param in params: param -= lr * param.grad / batch_size param.grad.zero_() # 这里不需要backward,调用前会有 # 除以batch_size是为了消除样本数量影响,也可以在损失函数里做这件事 # 最后记得置零训练
我们将执行以下循环:
- 初始化参数
- 重复以下训练,直到完成
- 计算梯度
- 更新参数
在每个迭代周期(epoch)中,我们使用data_iter函数遍历整个数据集, 并将训练数据集中所有样本都使用一次(假设样本数能够被批量大小整除)。
lr = 0.03num_epochs = 3net = linregloss = squared_loss
for epoch in range(num_epochs): for X, y in data_iter(batch_size, features, labels): l = loss(net(X, w, b), y) # X和y的小批量损失 # l不是标量,所以先求和再一次计算关于[w,b]的梯度 l.sum().backward() sgd([w, b], lr, batch_size) # 使用参数的梯度更新参数 with torch.no_grad(): train_l = loss(net(features, w, b), labels) print(f'epoch {epoch + 1}, loss {float(train_l.mean()):f}')epoch 1, loss 0.043519epoch 2, loss 0.000186epoch 3, loss 0.000051因为我们使用的是自己合成的数据集,所以我们知道真正的参数是什么。 因此,我们可以通过比较真实参数和通过训练学到的参数来评估训练的成功程度。 事实上,真实参数和通过训练学到的参数确实非常接近。
print(f'w的估计误差: {true_w - w.reshape(true_w.shape)}')print(f'b的估计误差: {true_b - b}')w的估计误差: tensor([ 0.0006, -0.0005], grad_fn=<SubBackward0>)b的估计误差: tensor([0.0014], grad_fn=<RsubBackward1>)线性回归的简洁实现、
生成数据集
%reset -fimport numpy as npimport torchfrom torch.utils import datafrom d2l import torch as d2l
true_w = torch.tensor([2, -3.4])true_b = 4.2features, labels = d2l.synthetic_data(true_w, true_b, 1000)读取数据集
我们将features和labels作为API的参数传递,并通过数据迭代器指定batch_size。 此外,布尔值is_train表示是否希望数据迭代器对象在每个迭代周期内打乱数据。
data.TensorDataset会把传入的多个张量按第0维对齐,打包成一个数据集对象。data.DataLoader把dataset里的数据按照batch_size切分,也就是表示提取一个批次。
def load_array(data_arrays, batch_size, is_train=True): """构造一个PyTorch数据迭代器""" dataset = data.TensorDataset(*data_arrays) # *代表传入列表 return data.DataLoader(dataset, batch_size, shuffle=is_train)
batch_size = 10data_iter = load_array((features, labels), batch_size)让我们验证data_iter是否正常工作,不同的是,这里我们使用iter构造Python迭代器,并使用next从迭代器中获取第一项。
next(iter(data_iter))[tensor([[ 0.6612, -0.4984], [ 0.4278, -0.3205], [ 0.4063, 0.6966], [ 2.4559, -0.7840], [-1.3373, -0.2614], [ 0.1336, 0.8636], [-0.4206, -1.0356], [-0.1262, -0.7577], [ 1.0042, -1.7507], [ 2.0587, -1.5202]]), tensor([[ 7.2251], [ 6.1376], [ 2.6432], [11.7681], [ 2.4054], [ 1.5214], [ 6.8723], [ 6.5146], [12.1557], [13.4834]])]定义模型
对于标准深度学习模型,我们可以使用框架的预定义好的层。这使我们只需关注使用哪些层来构造模型,而不必关注层的实现细节。我们首先定义一个模型变量net,它是一个Sequential类的实例,这个类可以将多个层串联在一起。
我们的模型只包含一个层,所以其实不需要Sequential,使用它是为了熟悉操作。
在PyTorch中,全连接层在Linear类中定义。我们将两个参数传递到nn.Linear中:
- 第一个: 输入特征的数量,也就是输入特征形状,即2。
- 第二个: 输出特征的数量,也就是输出特征形状,为单个标量,即1。
# nn是神经网络的缩写from torch import nn
net = nn.Sequential(nn.Linear(2, 1))初始化模型参数
我们使用weight.data和bias.data方法访问参数,normal_和fill_方法来重写参数值
net[0].weight.data.normal_(0, 0.01)net[0].bias.data.fill_(0)tensor([0.])定义损失函数
计算均方误差使用的是MSELoss类,也称为平方范数。 默认情况下,它返回所有样本损失的平均值。
loss = nn.MSELoss()定义优化算法
小批量随机梯度下降算法是一种优化神经网络的标准工具, PyTorch在optim模块中实现了该算法的许多变种。
net.parameters()会自动从我们的模型中获得优化的参数,我们在这里只需要设置lr值。
trainer = torch.optim.SGD(net.parameters(), lr = 0.03)训练
训练过程和从零开始实现所做的非常相似。对于每一个小批量,我们会进行以下步骤:
- 通过调用net(X)生成预测并计算损失l(前向传播)。
- 通过进行反向传播来计算梯度。
- 通过调用优化器来更新模型参数。
num_epochs = 3for epoch in range(num_epochs): for X, y in data_iter: l = loss(net(X), y) trainer.zero_grad() l.backward() trainer.step() l = loss(net(features), labels) print(f'epoch {epoch + 1}, loss {l:f}')epoch 1, loss 0.000173epoch 2, loss 0.000104epoch 3, loss 0.000103下面我们比较生成数据集的真实参数和通过有限数据训练获得的模型参数。 要访问参数,我们首先从net访问所需的层,然后读取该层的权重和偏置。
w = net[0].weight.dataprint('w的估计误差:', true_w - w.reshape(true_w.shape))b = net[0].bias.dataprint('b的估计误差:', true_b - b)w的估计误差: tensor([0.0009, 0.0006])b的估计误差: tensor([-0.0002])