7.3 网络中的网络(NiN)
LeNet、AlexNet和VGG都有一个共同的设计模式:通过一系列的卷积层与汇聚层来提取空间结构特征;然后通过全连接层对特征的表征进行处理。其中,AlexNet和VGG对LeNet做出了朴素的改进,即做得 “更深更大”。然而,如果使用了全连接层,会带来一些问题:
- 使用了全连接层,可能会完全放弃表征的空间结构。因为它把特征图里的每一个像素点强行连接到每一个输出的神经元上,这会破坏像素间的相对位置关系。
- 全连接层参数很多。这使得参数储存空间和占用的计算带宽都很大。
- 大尺寸全连接层容易引起过拟合。
既想增加非线性表达能力,又不想破坏空间结构,NiN给出了 “像素级(逐通道)的全连接”方案。
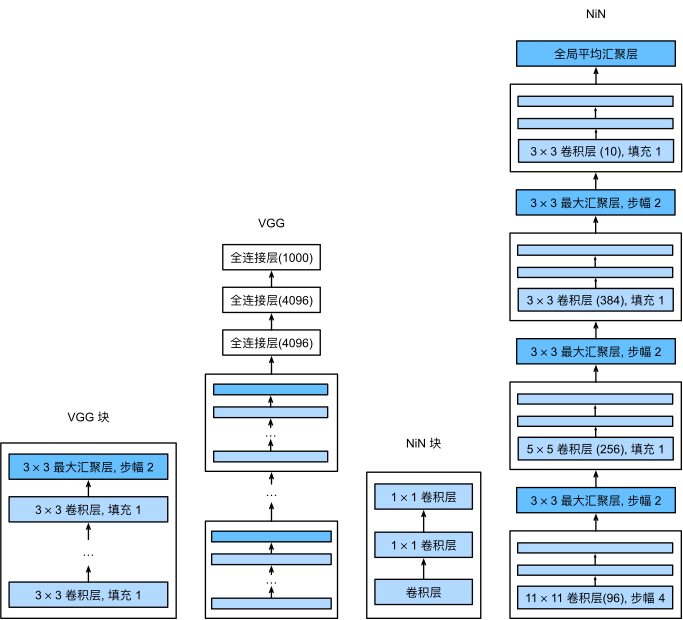
NiN块
如果我们将权重连接到每个空间位置,我们可以将其视为 卷积层,或作为在每个像素位置上独立作用的全连接层。从另一个角度看,即将空间维度中的每个像素视为单个样本,将通道维度视为不同特征(feature)。
import torchfrom torch import nnfrom d2l import torch as d2l
def nin_block(in_channels, out_channels, kernel_size, strides, padding): return nn.Sequential( nn.Conv2d(in_channels, out_channels, kernel_size, strides, padding), nn.ReLU(), nn.Conv2d(out_channels, out_channels, kernel_size=1), nn.ReLU(), nn.Conv2d(out_channels, out_channels, kernel_size=1), nn.ReLU() )NiN模型
最初的NiN网络是在AlexNet后不久提出的,显然从中得到了一些启示。 NiN使用窗口形状为 、 和 的卷积层,输出通道数量与AlexNet中的相同。 每个NiN块后有一个最大汇聚层,汇聚窗口形状为 ,步幅为2。
与AlexNet不同,NiN完全取消了全连接层,而且使用NiN块,其输出通道数等于标签类别的数量。最后放一个全局平均汇聚层(global average pooling layer),生成一个对数几率 (logits)。
net = nn.Sequential( nin_block(1, 96, kernel_size=11, strides=4, padding=0), nn.MaxPool2d(3, stride=2), nin_block(96, 256, kernel_size=5, strides=1, padding=2), nn.MaxPool2d(3, stride=2), nin_block(256, 384, kernel_size=3, strides=1, padding=1), nn.MaxPool2d(3, stride=2), nn.Dropout(0.5), # 这里怎么整了个Dropout? # 标签类别数是10 nin_block(384, 10, kernel_size=3, strides=1, padding=1), nn.AdaptiveAvgPool2d((1, 1)), # 将四维的输出转成二维的输出,其形状为(批量大小,10) nn.Flatten())
X = torch.rand(size=(1, 1, 224, 224))for layer in net: X = layer(X) print(layer.__class__.__name__, 'output shape:\t', X.shape)Sequential output shape: torch.Size([1, 96, 54, 54])MaxPool2d output shape: torch.Size([1, 96, 26, 26])Sequential output shape: torch.Size([1, 256, 26, 26])MaxPool2d output shape: torch.Size([1, 256, 12, 12])Sequential output shape: torch.Size([1, 384, 12, 12])MaxPool2d output shape: torch.Size([1, 384, 5, 5])Dropout output shape: torch.Size([1, 384, 5, 5])Sequential output shape: torch.Size([1, 10, 5, 5])AdaptiveAvgPool2d output shape: torch.Size([1, 10, 1, 1])Flatten output shape: torch.Size([1, 10])训练模型
lr, num_epochs, batch_size = 0.1, 10, 128train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=224)d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())loss 0.579, train acc 0.779, test acc 0.7651524.3 examples/sec on cuda:0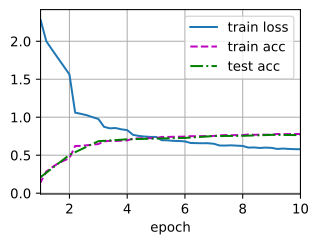
这里效果其实不如AlexNet,可能是数据集比较小的原因。实际上NiN在ImageNet上的表现是优于AlexNet的。
小结
-
NiN使用由一个卷积层和多个 卷积层组成的块。该块可以在卷积神经网络中使用,以允许更多的每像素非线性。
-
NiN去除了容易造成过拟合的全连接层,将它们替换为全局平均汇聚层(即在所有位置上进行求和)。该汇聚层通道数量为所需的输出数量(例如,Fashion-MNIST的输出为10)。
-
移除全连接层可减少过拟合,同时显著减少NiN的参数。
-
NiN的设计影响了许多后续卷积神经网络的设计。
本文由 kaikaikk 原创,发布于
;
转载请保留原文链接:
https://kaikaikk.com/posts/d2l-7-3-nin/