7.7 稠密连接网络(DenseNet)
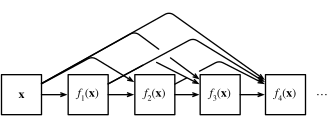
DenseNet 使用了一种极简的连接模式:为了确保网络中最大程度的信息流动,将所有层(以匹配的特征图大小)直接连接起来。
传统卷积网络若有 L 层,则有 L 个连接(每层与其后一层之间一个连接);而 DenseNet 有 L(L+1)/2 个直接连接。
从 ResNet 到 DenseNet
ResNet 将函数展开为:
也就是说,ResNet 将 分解为两部分:
- 一个简单的线性项
- 一个复杂的非线性项
它通过相加(element-wise addition) 的方式,将恒等映射与残差函数结合起来。
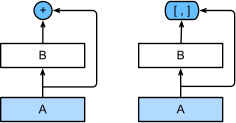
如图1,DenseNet 的关键区别在于:输出是连接(concatenation) 而非相加。
数学上可以表示为:
这意味着每一层的输入来自前面所有层的特征图拼接,而非仅来自前一层的相加结果。
| 对比维度 | ResNet | DenseNet |
|---|---|---|
| 连接方式 | Element-wise Addition | Concatenation(拼接) |
| 特征融合 | 相加(需要维度一致) | 拼接(保留全部信息) |
| 每层输入 | 前一层的输出 + 恒等映射 | 前面所有层的输出拼接 |
| 信息流动 | 跨层相加 | 跨层直接连接 |
最后,将这些展开式结合到多层感知机中,再次减少特征的数量。 DenseNet这个名字由变量之间的“稠密连接”而得来,最后一层与之前的所有层紧密相连。
稠密网络主要由2部分构成: 稠密块(dense block) 和 过渡层(transition layer) 。 前者定义如何连接输入和输出,而后者则控制通道数量,使其不会太复杂。
稠密块(Dense Block)
稠密块是 DenseNet 的核心构建单元。在稠密块内部,每一层都接收前面所有层的特征图作为输入,并将自己的输出传递给后续所有层。
每一层通常采用ResNet改良版的 “ BN → ReLU → Conv(3×3)” 的顺序(即 pre-activation 设计,可参考这篇论文)。我们首先来实现一下这个架构。
import torchfrom torch import nnfrom d2l import torch as d2l
def conv_block(input_channels, num_channels): return nn.Sequential( nn.BatchNorm2d(input_channels), nn.ReLU(), nn.Conv2d(input_channels, num_channels, kernel_size=3, padding=1) )增长率(Growth Rate):记作 ,表示稠密块中每一层输出的特征图通道数。由于采用拼接方式连接,每经过一层,后续层的输入通道数就会增加 。假设稠密块的初始输入通道数为 ,则第 层的输入通道数为 。
通常使用较小的增长率(如 或 ),这使得 DenseNet 的层非常窄(每层仅 12 个特征图)。
一个稠密块由多个卷积块组成,每个卷积块使用相同数量的输出通道。 然而,在前向传播中,我们将每个卷积块的输入和输出在通道维上连结。
class DenseBlock(nn.Module): def __init__(self, num_convs, input_channels, num_channels): super().__init__() layer = [] for i in range(num_convs): layer.append(conv_block( num_channels * i + input_channels, num_channels )) self.net = nn.Sequential(*layer)
def forward(self, X): for blk in self.net: Y = blk(X) # 连接通道维度上每个块的输入和输出 X = torch.cat((X, Y), dim=1) return X我们定义一个有2个输出通道数为10的DenseBlock。 使用通道数为3的输入时,我们会得到通道数为 的输出。
blk = DenseBlock(2, 3, 10)X = torch.randn(4, 3, 8, 8)Y = blk(X)Y.shapetorch.Size([4, 23, 8, 8])过渡层(Transition Layer)
稠密块内每经过一层,通道数就会增加 ,因此随着层数增加,通道数会迅速增长。过渡层的作用是控制模型复杂度,防止通道数膨胀过快。
过渡层通常包含:
- 1×1 卷积:用于减少通道数(通常压缩到当前输入的一半)
- 2×2 平均池化:用于降低特征图的空间尺寸
如果稠密块包含 个特征图,过渡层会将其输出通道数压缩为 ,其中 称为压缩因子(compression factor),通常设为0.5,意味着过渡层会将特征图的通道数减半。当 时,通道数保持不变。
def transition_block(input_channels, num_channels): return nn.Sequential( nn.BatchNorm2d(input_channels), nn.ReLU(), nn.Conv2d(input_channels, num_channels, kernel_size=1), nn.AvgPool2d(kernel_size=2, stride=2) )对上一个例子中稠密块的输出使用通道数为10的过渡层。 此时输出的通道数减为10,高和宽均减半。
blk = transition_block(23, 10)blk(Y).shapetorch.Size([4, 10, 4, 4])DenseNet模型
我们来构造DenseNet模型。DenseNet首先使用同ResNet一样的单卷积层和最大汇聚层。
b1 = nn.Sequential( nn.Conv2d(1, 64, kernel_size=7, stride=2, padding=3), nn.BatchNorm2d(64), nn.ReLU(), nn.MaxPool2d(kernel_size=3, stride=2, padding=1))接下来,类似于ResNet使用的4个残差块,DenseNet使用的是4个稠密块。我们设置每个稠密块使用4个卷积层,从而与之前的ResNet-18保持一致。增长率设为32,每个稠密块将增加128个通道。
在每个模块之间,ResNet通过步幅为2的残差块减小高和宽,DenseNet则使用过渡层来减半高和宽,并减半通道数。
# num_channels为当前的通道数num_channels, growth_rate = 64, 32num_convs_in_dense_blocks = [4, 4, 4, 4]blks = []for i, num_convs in enumerate(num_convs_in_dense_blocks): blks.append(DenseBlock(num_convs, num_channels, growth_rate)) # 上一个稠密块的输出通道数 num_channels += num_convs * growth_rate # 在稠密块之间添加一个转换层,使通道数量减半 if i != len(num_convs_in_dense_blocks) - 1: blks.append(transition_block(num_channels, num_channels //2)) num_channels = num_channels // 2
# 与ResNet类似,最后接上全局汇聚层和全连接层来输出结果net = nn.Sequential( b1, *blks, nn.BatchNorm2d(num_channels), nn.ReLU(), nn.AdaptiveAvgPool2d((1, 1)), nn.Flatten(), nn.Linear(num_channels, 10))训练模型
由于这里使用了比较深的网络,本节里我们将输入高和宽从224降到96来简化计算。
lr, num_epochs, batch_size = 0.1, 10, 256train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=96)d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())loss 0.142, train acc 0.948, test acc 0.8843078.6 examples/sec on cuda:0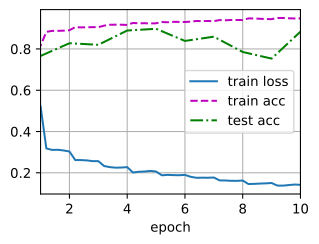
DenseNet 的优势
- 缓解梯度消失。
- 强化特征传播与复用:每一层都能访问前面所有层的特征图,鼓励特征复用(feature reuse) 而非每层重新学习特征。这种设计使得网络可以用更少的参数学习到更丰富的表示。
- 减少参数量:DenseNet 的一个显著特点是网络更窄、参数更少。这主要得益于两点:
- 每一层的输出通道数 很小
- 特征复用使得不需要每层都学习大量新特征
- 正则化效果
DenseNet 变体
原始论文中提出了几种变体:
- DenseNet-B:引入 Bottleneck 层(在 3×3 卷积前增加 1×1 卷积),进一步减少参数和计算量
- DenseNet-C:使用压缩因子 的过渡层
- DenseNet-BC:同时使用 Bottleneck 和压缩
对于 ImageNet 任务,论文设计了 DenseNet-121、DenseNet-169、DenseNet-201、DenseNet-264 等不同深度的变体。
总结
-
DenseNet 的核心创新可以概括为:将每一层与所有其他层直接连接。
-
这一极简的设计带来了多重收益——缓解梯度消失、强化特征传播与复用、减少参数量,使得 DenseNet 在参数效率和性能之间取得了出色的平衡。
-
从 ResNet 到 DenseNet,核心演进路径是:从跨层相加到跨层拼接,从残差学习到特征复用,从深而宽到深而窄。这一范式转变深刻影响了后续卷积神经网络的设计思路。